Runpod
Visitar o siteGPUs na nuvem e endpoints Serverless para treinar, fazer fine-tuning e executar modelos de IA.
Verificado em 2 de nov. de 2026
O que é Runpod?
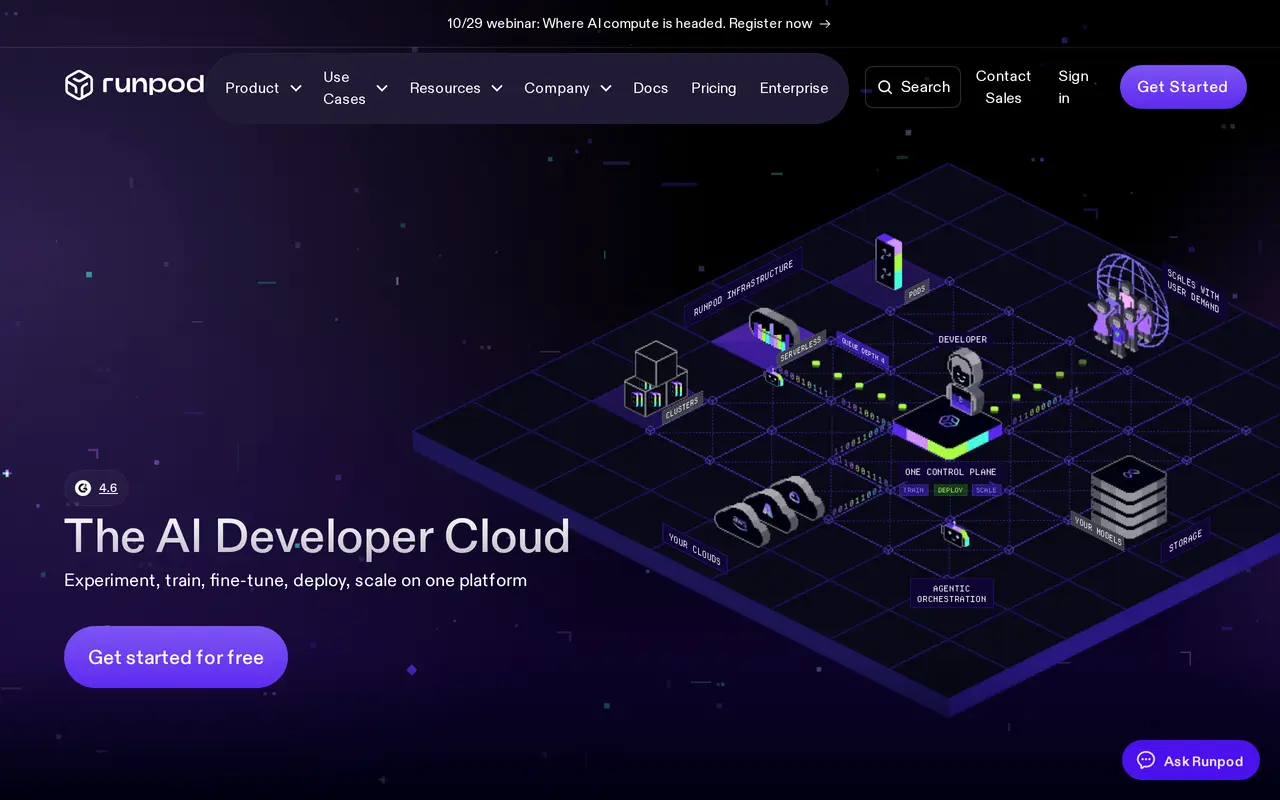
Runpod é uma plataforma de nuvem para desenvolver e executar cargas de trabalho de IA. Oferece instâncias dedicadas de GPU chamadas Pods, endpoints de inferência Serverless com escalonamento automático e Clusters com vários nós para tarefas distribuídas. Os desenvolvedores podem experimentar modelos, fazer fine-tuning e implantar serviços de inferência na mesma conta.
É possível iniciar ambientes de GPU com containers, frameworks e código próprios ou implantar modelos de código aberto e templates pelo Runpod Hub. Nas implantações Serverless, os desenvolvedores escrevem um handler e disponibilizam a carga de trabalho por um endpoint de API. O Runpod gerencia filas de requisições, atribuição de workers, escalonamento automático, logs e métricas. Os Public Endpoints também oferecem acesso por API a modelos de imagem, vídeo, linguagem e áudio já implantados, sem precisar configurar infraestrutura.
A plataforma oferece mais de 30 opções de GPU em 31 regiões, além de armazenamento persistente. A cobrança depende da carga de trabalho: instâncias dedicadas de GPU, workers de inferência, requisições a modelos e armazenamento têm tarifas de uso separadas. Há opções de capacidade reservada e contratos empresariais para equipes que precisam de recursos garantidos ou implantações maiores.
O que Runpod faz?
GPU Pods sob demanda
Inicie ambientes dedicados de GPU para desenvolvimento, treinamento e fine-tuning de modelos, além de cargas de trabalho de longa duração.
Inferência Serverless
Implante endpoints de API com filas de requisições gerenciadas e workers que escalam conforme a demanda.
Clusters de GPU com vários nós
Execute cargas de trabalho distribuídas em clusters de GPU com armazenamento compartilhado e capacidade reservada opcional.
APIs de modelos já implantados
Faça chamadas a modelos hospedados de imagem, vídeo, áudio e linguagem sem configurar sua própria infraestrutura de GPU.
Modelos e templates de implantação
Use o Runpod Hub para implantar modelos de código aberto e templates ou utilize seus próprios containers e código.
Monitoramento e armazenamento persistente
Acesse logs de execução, métricas e armazenamento persistente em rede para cargas de trabalho de IA implantadas.
Para quem é Runpod?
- Desenvolvedores de IA
- Crie, teste, faça fine-tuning e disponibilize modelos usando ambientes de GPU e APIs de inferência.
- Equipes de machine learning
- Execute treinamentos e cargas de trabalho distribuídas com opções de hardware de GPU e configurações de cluster.
- Equipes de aplicativos de IA
- Escale serviços de inferência em produção com workers gerenciados e cobrança por uso.
Quanto custa Runpod?
Preços oficiaisB300
US$ 8,99
H200
US$ 5,29
B200
US$ 7,99
RTX Pro 6000
US$ 2,49
H100 NVL
US$ 3,19
H100 PCIe
US$ 2,89
H100 SXM
US$ 3,99
A100 PCIe
US$ 1,79
A100 SXM
US$ 1,79
Pro 6000 MIG 48GB
US$ 1,29
L40S
US$ 1,09
RTX 6000 Ada
US$ 0,99
Plano gratuito: O endpoint público resembleai / Chatterbox Turbo é gratuito, com tarifa de US$ 0,00 por 1.000 caracteres.
Perguntas frequentes
Como o Runpod cobra pelo processamento em GPU?
Os preços variam conforme a GPU e o tipo de implantação. Os Pods têm tarifas de instância dedicada, o Serverless cobra pelo uso dos workers de inferência e os Clusters têm tarifas próprias; os preços de GPU apresentados são por hora, não assinaturas mensais.
Posso implantar meus próprios modelos e containers?
Sim. O Runpod permite usar containers, frameworks e código próprios, além de modelos de código aberto e templates de implantação pelo Runpod Hub.
Posso fazer chamadas a modelos sem gerenciar infraestrutura de GPU?
Sim. Os Public Endpoints oferecem acesso por API a modelos já implantados, com preços definidos conforme o modelo e sua unidade de cobrança.
O Serverless cobra enquanto um endpoint está ocioso?
Os endpoints Serverless podem escalar até zero, sem cobrança de processamento do endpoint quando não estão em execução. O armazenamento é cobrado separadamente.
É possível reservar GPUs?
Sim. O Runpod oferece clusters reservados e preços por contrato por meio de sua equipe de vendas empresariais.
Alternativas a Runpod
Comparar alternativas- 1
 OpenAIModelos de IA, ChatGPT e uma plataforma de API para uso pessoal, empresarial e em desenvolvimento.
- 2
 MiniMaxModelos de IA, APIs e aplicativos para linguagem, vídeo, fala e música.
- 3
 OpenRouterAcesse modelos de IA de vários provedores por uma única API e interface de chat.
- 4
 MistralModelos de IA, agentes e ferramentas de desenvolvimento para uso em serviços hospedados ou ambientes privados.
- 5
 CursorEditor de código e agente de IA para criar, testar e revisar software.