Runpod
Visiter le siteGPU cloud et endpoints Serverless pour entraîner, affiner et exécuter des modèles d’IA.
Vérifié le 2 nov. 2026
Qu'est-ce que Runpod ?
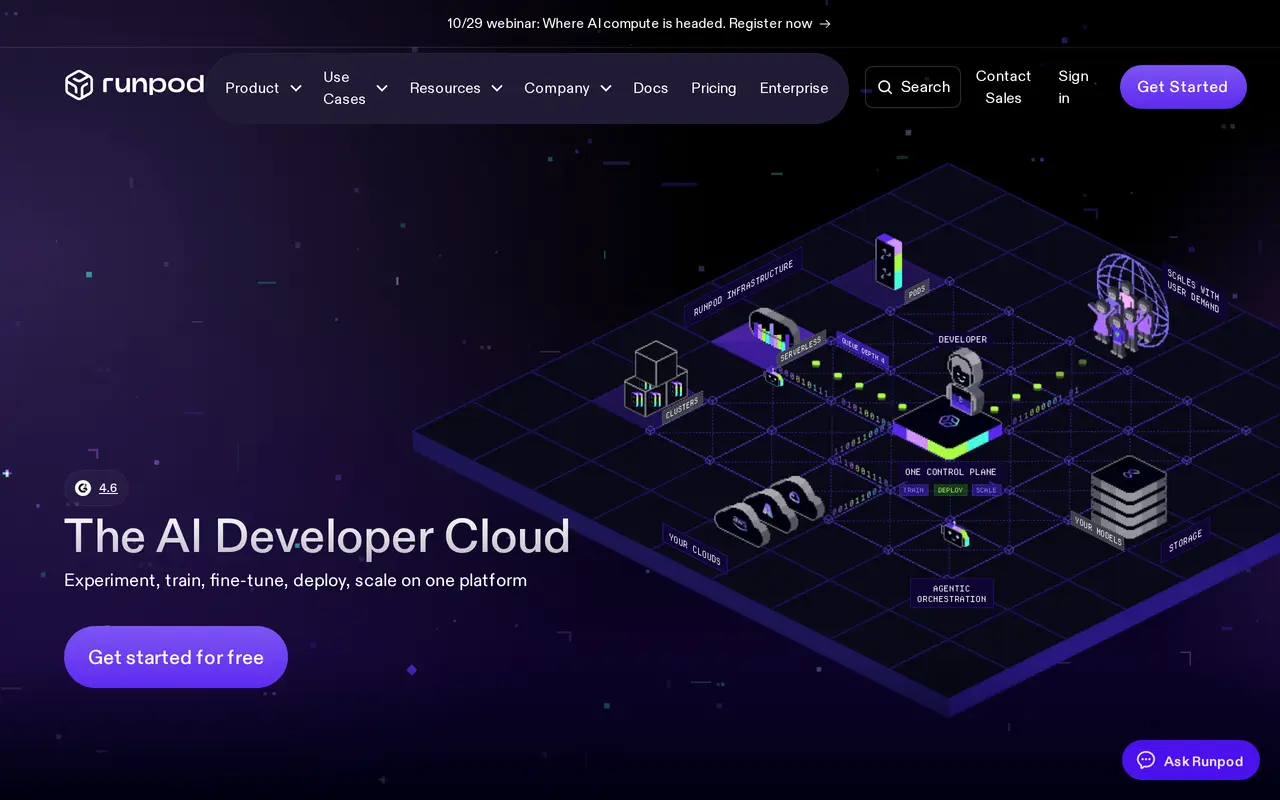
Runpod est une plateforme cloud pour développer et exécuter des charges de travail d’IA. Elle propose des instances GPU dédiées appelées Pods, des endpoints d’inférence Serverless à mise à l’échelle automatique et des Clusters multinœuds pour les traitements distribués. Les développeurs peuvent ainsi expérimenter avec des modèles, les affiner et déployer des services d’inférence depuis un même compte.
Les environnements GPU peuvent être lancés avec des conteneurs, frameworks et du code personnalisés, ou à partir de modèles open source et de templates disponibles dans Runpod Hub. Pour les déploiements Serverless, les développeurs écrivent un handler et rendent leur traitement accessible via un endpoint API. Runpod gère les files de requêtes, l’attribution des workers, la mise à l’échelle automatique, les logs et les métriques. Public Endpoints donne aussi accès par API à des modèles d’image, de vidéo, de langage et d’audio prédéployés, sans infrastructure à configurer.
La plateforme propose plus de 30 options de GPU réparties dans 31 régions, ainsi qu’un stockage persistant. La facturation dépend de l’usage : les instances GPU dédiées, les workers d’inférence, les requêtes aux modèles et le stockage ont chacun leurs tarifs. Des capacités réservées et des contrats entreprise sont disponibles pour les équipes qui ont besoin de ressources garanties ou de déploiements plus importants.
Que peut faire Runpod ?
GPU Pods à la demande
Lancement d’environnements GPU dédiés au développement, à l’entraînement et à l’affinage de modèles, ainsi qu’aux traitements de longue durée.
Inférence Serverless
Déploiement d’endpoints API avec des files de requêtes gérées et un nombre de workers qui s’adapte à la demande.
Clusters GPU multinœuds
Exécution de traitements distribués sur des clusters GPU avec stockage partagé et possibilité de réserver de la capacité.
API de modèles prédéployés
Appel de modèles hébergés d’image, de vidéo, d’audio et de langage sans avoir à configurer sa propre infrastructure GPU.
Modèles et templates de déploiement
Déploiement de modèles open source et de templates via Runpod Hub, ou utilisation de conteneurs et de code personnalisés.
Supervision et stockage persistant
Accès aux logs d’exécution, aux métriques et à un stockage réseau persistant pour les charges de travail d’IA déployées.
À qui s'adresse Runpod ?
- Développeurs en IA
- Développer, tester, affiner et servir des modèles à l’aide d’environnements GPU et d’API d’inférence.
- Équipes de machine learning
- Exécuter des entraînements et des traitements distribués avec un choix de GPU et de configurations de clusters.
- Équipes d’applications d’IA
- Adapter la capacité des services d’inférence en production grâce à des workers gérés et à une facturation à l’usage.
Combien coûte Runpod ?
Tarifs officielsB300
8,99 $US
H200
5,29 $US
B200
7,99 $US
RTX Pro 6000
2,49 $US
H100 NVL
3,19 $US
H100 PCIe
2,89 $US
H100 SXM
3,99 $US
A100 PCIe
1,79 $US
A100 SXM
1,79 $US
Pro 6000 MIG 48GB
1,29 $US
L40S
1,09 $US
RTX 6000 Ada
0,99 $US
Offre gratuite: L’endpoint public resembleai / Chatterbox Turbo est gratuit, au tarif de 0,00 $ pour 1 000 caractères.
Questions fréquentes
Comment Runpod facture-t-il le calcul GPU ?
Les tarifs varient selon le GPU et le type de déploiement. Les Pods sont facturés au tarif des instances dédiées, Serverless selon l’utilisation des workers d’inférence, et Clusters dispose de tarifs distincts. Les prix des GPU affichés sont des tarifs horaires, et non des abonnements mensuels.
Puis-je déployer mes propres modèles et conteneurs ?
Oui. Runpod prend en charge les conteneurs, frameworks et le code personnalisés, ainsi que les modèles open source et les templates de déploiement proposés dans Runpod Hub.
Puis-je appeler des modèles sans gérer d’infrastructure GPU ?
Oui. Public Endpoints donne accès par API à des modèles prédéployés, avec une tarification qui dépend du modèle et de son unité de facturation.
Serverless est-il facturé lorsqu’un endpoint est inactif ?
Les endpoints Serverless peuvent réduire leur nombre de workers à zéro : aucun calcul n’est alors facturé pour un endpoint qui ne s’exécute pas. Le stockage est facturé séparément.
Est-il possible de réserver des GPU ?
Oui. Runpod propose des clusters réservés et des tarifs contractuels par l’intermédiaire de son équipe commerciale entreprise.
Alternatives à Runpod
Comparer les alternatives- 1
 OpenAIDes modèles d’IA, ChatGPT et une plateforme API pour les particuliers, entreprises et développeurs.
- 2
 MiniMaxModèles d’IA, API et applications pour le langage, la vidéo, la parole et la musique.
- 3
 OpenRouterAccédez aux modèles d’IA de plusieurs fournisseurs via une API et une interface de chat uniques.
- 4
 MistralModèles d’IA, agents et outils de développement à déployer en service hébergé ou sur infrastructure privée.
- 5
 CursorUn éditeur de code et un agent IA pour développer, tester et relire des logiciels.