Runpod
Visitar el sitioGPU en la nube y endpoints serverless para entrenar, ajustar y ejecutar modelos de IA.
Verificado el 2 nov 2026
¿Qué es Runpod?
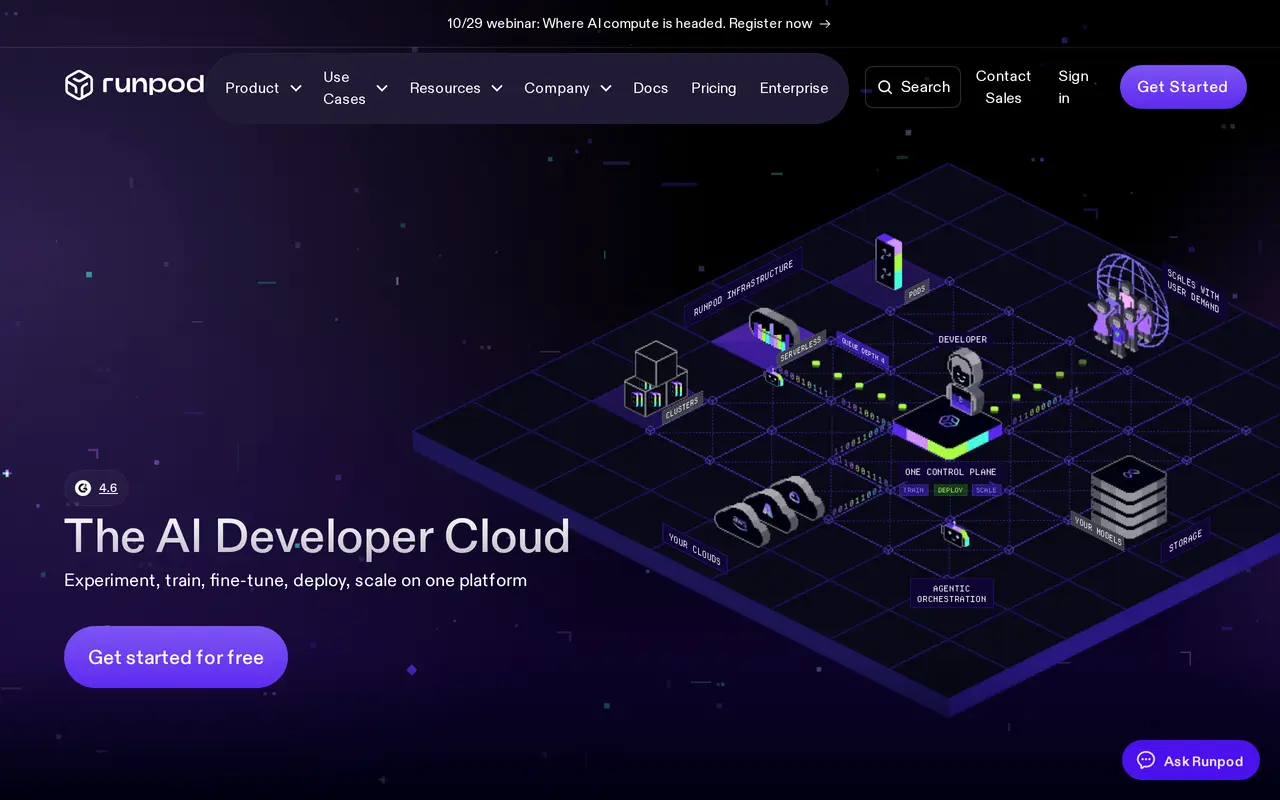
Runpod es una plataforma en la nube para desarrollar y ejecutar cargas de trabajo de IA. Ofrece instancias de GPU dedicadas llamadas Pods, endpoints de inferencia Serverless con escalado automático y Clusters multinodo para tareas distribuidas. Permite experimentar con modelos, hacer fine-tuning y desplegar servicios de inferencia desde una misma cuenta.
Los usuarios pueden iniciar entornos de GPU con sus propios contenedores, frameworks y código, o desplegar modelos de código abierto y plantillas a través de Runpod Hub. Para los despliegues Serverless, los desarrolladores escriben un handler y exponen su carga de trabajo mediante un endpoint de API. Runpod gestiona las colas de solicitudes, la asignación de workers, el escalado automático, los logs y las métricas. Public Endpoints también ofrece acceso por API a modelos de imagen, vídeo, lenguaje y audio ya desplegados, sin configurar infraestructura.
La plataforma ofrece más de 30 opciones de GPU en 31 regiones, además de almacenamiento persistente. La facturación depende de la carga de trabajo: las instancias de GPU dedicadas, los workers de inferencia, las solicitudes a modelos y el almacenamiento tienen tarifas de uso independientes. Hay capacidad reservada y contratos empresariales para equipos que necesitan recursos garantizados o despliegues de mayor escala.
¿Qué puede hacer Runpod?
Pods de GPU bajo demanda
Permiten iniciar entornos de GPU dedicados para desarrollar y entrenar modelos, hacer fine-tuning y ejecutar cargas de trabajo de larga duración.
Inferencia Serverless
Permite desplegar endpoints de API con colas de solicitudes gestionadas y workers que escalan según la demanda.
Clusters de GPU multinodo
Permiten ejecutar cargas de trabajo distribuidas en clusters de GPU con almacenamiento compartido y capacidad reservada opcional.
API de modelos ya desplegados
Ofrecen acceso a modelos alojados de imagen, vídeo, audio y lenguaje sin configurar infraestructura de GPU propia.
Modelos y plantillas de despliegue
Runpod Hub permite desplegar modelos de código abierto y plantillas, y también se pueden usar contenedores y código propios.
Monitorización y almacenamiento persistente
Ofrece acceso a logs de ejecución, métricas y almacenamiento de red persistente para las cargas de trabajo de IA desplegadas.
¿Para quién es Runpod?
- Desarrolladores de IA
- Pueden crear, probar, ajustar y servir modelos mediante entornos de GPU y API de inferencia.
- Equipos de machine learning
- Pueden ejecutar entrenamientos y cargas de trabajo distribuidas con distintas opciones de hardware de GPU y configuraciones de clusters.
- Equipos de aplicaciones de IA
- Pueden escalar servicios de inferencia en producción con workers gestionados y facturación por uso.
¿Cuánto cuesta Runpod?
Precios oficialesB300
8,99 US$
H200
5,29 US$
B200
7,99 US$
RTX Pro 6000
2,49 US$
H100 NVL
3,19 US$
H100 PCIe
2,89 US$
H100 SXM
3,99 US$
A100 PCIe
1,79 US$
A100 SXM
1,79 US$
Pro 6000 MIG 48GB
1,29 US$
L40S
1,09 US$
RTX 6000 Ada
0,99 US$
Plan gratuito: El endpoint público resembleai / Chatterbox Turbo es gratuito, con una tarifa de $0.00 por 1,000 caracteres.
Preguntas frecuentes
¿Cómo cobra Runpod por el cómputo con GPU?
Los precios varían según la GPU y el tipo de despliegue. Pods aplica tarifas de instancias dedicadas, Serverless cobra por el uso de workers de inferencia y Clusters tiene tarifas independientes; los precios de GPU publicados son tarifas por hora, no suscripciones mensuales.
¿Puedo desplegar mis propios modelos y contenedores?
Sí. Runpod admite contenedores, frameworks y código propios, además de modelos de código abierto y plantillas de despliegue a través de Runpod Hub.
¿Puedo acceder a modelos sin gestionar infraestructura de GPU?
Sí. Public Endpoints ofrece acceso por API a modelos ya desplegados, con precios que dependen del modelo y de su unidad de facturación.
¿Serverless cobra mientras un endpoint está inactivo?
Los endpoints Serverless pueden escalar a cero, sin cargos de cómputo del endpoint cuando no están en ejecución. El almacenamiento se cobra por separado.
¿Hay GPU reservadas disponibles?
Sí. Runpod ofrece clusters reservados y precios por contrato a través de su equipo de ventas empresariales.
Alternativas a Runpod
Comparar alternativas- 1
 ReplicateEjecuta, ajusta y despliega modelos de IA mediante una API en la nube.
- 2
 OpenAIModelos de IA, ChatGPT y una plataforma API para uso personal, empresarial y de desarrollo.
- 3
 MiniMaxModelos de IA, API y aplicaciones para lenguaje, vídeo, voz y música.
- 4
 OpenRouterAccede a modelos de IA de varios proveedores desde una sola API y una interfaz de chat.
- 5
 MistralModelos de IA, agentes y herramientas de desarrollo para despliegues alojados o privados.
Más en APIs de modelos
Ver más
fal
APIs de modelos
Accede a modelos de IA generativa con una sola API y despliégalos en GPU serverless.
Stability AI
Modelos de IA
Modelos y herramientas de IA generativa para crear imágenes, audio, vídeo y recursos 3D.
ZenMux
Pasarelas de API de IA
Acceso a 100+ modelos de IA desde una API con selección automática y seguimiento del uso.
APIQIK
Pasarelas de API de IA
Accede a varios modelos de IA con una API compatible con OpenAI y conmutación automática entre nodos.
Bluesminds
Agentes de IA
Conecta datos empresariales, analízalos con IA y crea agentes autónomos.