Boogu-Image-0.1とは?
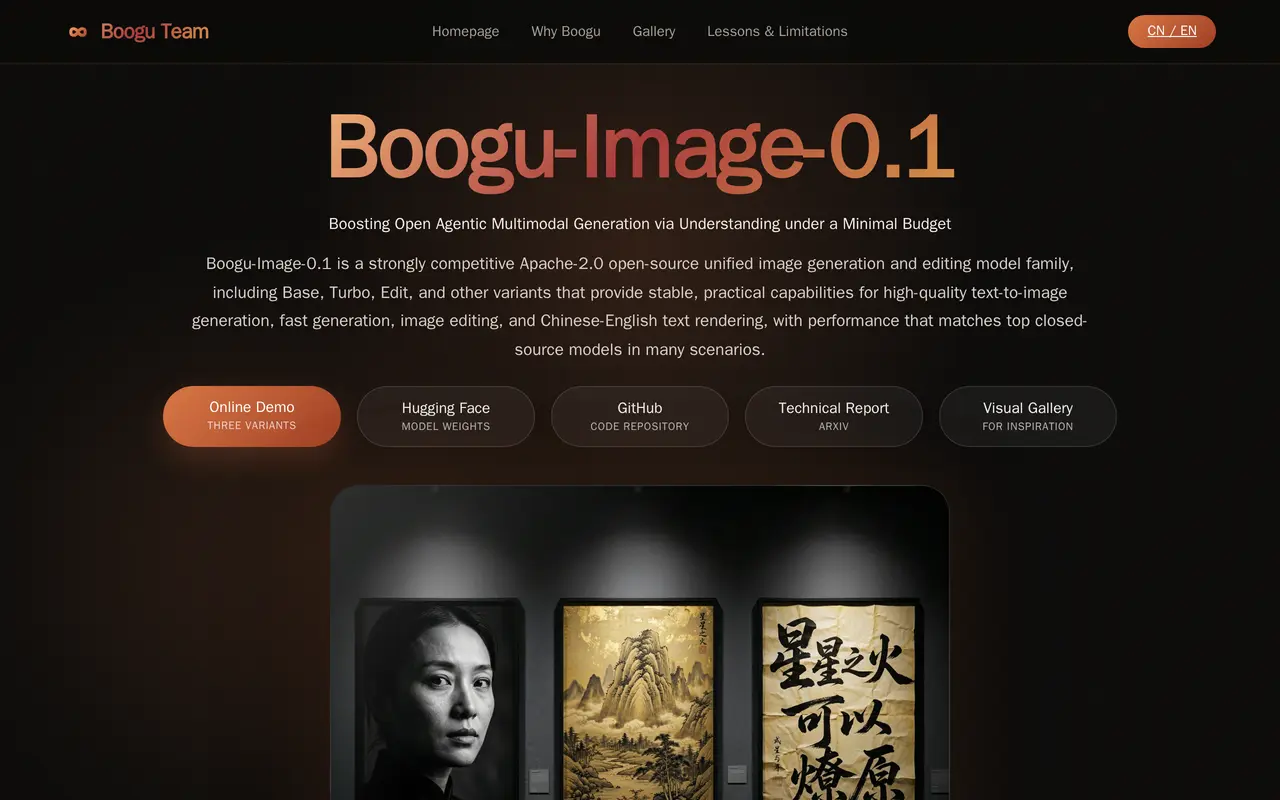
Boogu-Image-0.1は、テキストからの画像生成と自然言語の指示による既存画像の編集に対応する、Apache-2.0のオープンソース画像モデル群です。写真風の画像やさまざまな画風の画像に加え、中国語と英語の文字描画にも対応し、ポスターやインターフェースなど、文字を多く使うデザインに利用できます。オンラインデモで試せるほか、モデルの重みとコードを入手して独自のワークフローに組み込めます。
用途や導入環境に応じた複数のモデルがあります。Baseは、細部まで描き込む画像生成、文字量の多い画像、ファインチューニング、派生開発に向けたモデルです。Turboは蒸留版で、通常3〜4回の推論ステップを使い、写真のような表現を重視しています。FP8版は、導入時に必要なメモリを抑えられます。EditとEdit-Turboは、中国語と英語の指示で部分的な調整や創造的な変換を行う、画像から画像へのワークフローに対応します。
利用上の制約もあります。編集では、特に構造や視点を大きく変える指示を出すと、維持したい被写体の同一性、レイアウト、細部まで変わることがあります。文字量の多い画像、小さな文字、複雑なポーズ、顔の細部でも誤りが生じる場合があります。文字描画は中国語と英語向けに最適化されており、ほかの言語向けではありません。コードと重みは公開されていますが、学習やシステムに関する詳細のすべてが公開されているわけではありません。
Boogu-Image-0.1でできること
テキストからの画像生成
プロンプトから写真風やさまざまな画風の画像を生成でき、ワークフローに応じてBaseとTurboを使えます。
指示による画像編集
中国語または英語の指示で、既存画像の部分的な調整や創造的な変換を行えます。
中国語・英語の文字描画
ポスター、インターフェース、ブランドガイドなどのレイアウト向けに、中国語と英語の文字を含む画像を作成できます。
高速なTurboモデル
Turboモデルでは、通常3〜4回の推論ステップで画像の生成や編集を行えます。
省メモリでの導入
FP8量子化版を使うことで、推論に必要なメモリを抑えられます。
コードとモデルの重みを公開
Apache-2.0で公開されたコードと重みを、導入、ファインチューニング、派生開発に利用できます。
Boogu-Image-0.1が向いている人
- デザイナー・ビジュアル制作者
- 写真風の画像、さまざまな画風の画像、文字を多く含むビジュアルを生成したり、自然言語の指示で画像を編集したりできます。
- モデル開発者・研究者
- 公開されたコードと重みを、ファインチューニング、導入、画像生成や編集の研究に利用できます。
よくある質問
Boogu-Image-0.1はオープンソースですか?
はい。コードとモデルの重みはApache-2.0で公開されています。ただし、学習やシステムに関する詳細のすべてが公開されているわけではありません。
モデルを自分で導入せずに試せますか?
Base、Turbo、Edit、Edit-Turboのオンラインデモを利用できます。
文字描画はどの言語に対応していますか?
文字描画は中国語と英語を中心に対応しています。ほかの言語向けには特に最適化されておらず、文字量が多い場合や小さな文字では誤りが生じることもあります。
画像編集にはどのような制約がありますか?
編集時に、被写体の同一性、レイアウト、細部を確実に維持できるとは限りません。視点や構造を大きく変える編集も、写真の見た目を調整する編集に比べて制約があります。